SCOTUS-Net
1Resumen ejecutivo
En respuesta a los retos que plantea predecir los fallos del Tribunal Supremo de los Estados Unidos (SCOTUS), presentamos SCOTUS-Net, un aprendiz legal zero-shot diseñado para superar los dos obstáculos principales de los modelos anteriores: el data drift y el cold-start. A diferencia de los enfoques existentes, optimizados sobre patrones de voto históricos y datos estructurados, SCOTUS-Net utiliza información biográfica para inferir las tendencias judiciales. Esto permite predicciones fiables incluso ante Jueces recién nombrados sin historial de votación, o ante composiciones hipotéticas del Tribunal.
El sistema integra una arquitectura de doble pipeline, basada en sentence transformers, para procesar tanto las descripciones de los casos como las biografías de los Jueces, con una etapa de preentrenamiento que garantiza que las biografías truncadas codifiquen información relevante sobre el mandato. Los experimentos, sobre más de nueve mil casos del período 1946–2023, demuestran que SCOTUS-Net mantiene su robustez ante los cambios de distribución del panorama legal y político. Aunque persisten limitaciones, en particular en explicabilidad y en granularidad por Juez, los resultados sugieren que las representaciones biográficas ofrecen una base potente y escalable para el modelado predictivo legal.
2Motivación y estado del arte
En junio de 2025, The Economist presentó SCOTUSbot [1], un modelo experimental de deep learning, basado en un modelo de lenguaje de gran tamaño (LLM), que predice los fallos del Tribunal Supremo (SCOTUS) a partir de la descripción de un caso. Funciona incitando a un LLM con la descripción del caso y la identidad de los Jueces para asignar una puntuación por Juez. Esto se repite varias veces como un experimento "Monte-Carlo", y los resultados se agregan para aproximar tanto la puntuación por Juez como una predicción a nivel de Tribunal. Una propiedad útil de este diseño es la interpretabilidad: las puntuaciones extremas (v.g.: 0/10 o 10/10) indican mayor certeza del modelo respecto a un Juez, mientras que las puntuaciones intermedias (v.g.: 5/10) reflejan incertidumbre. Esto permite un análisis de tendencias por Juez y la identificación de escenarios de voto decisivo.
Sin embargo, SCOTUSbot enfrenta dos retos importantes: el data drift y el cold-start. Puesto que depende principalmente del corpus de entrenamiento del LLM para predecir el voto de Jueces concretos, cualquier cambio en la composición del Tribunal desplaza la distribución condicional de la que depende el modelo — un drift a nivel de Tribunal. A nivel de Juez, un nombramiento reciente carece de historial de voto, lo que hace inviable un ajuste inmediato. En consecuencia, un nuevo nombramiento puede inutilizar el modelo hasta que se acumulen suficientes datos nuevos.
Para abordar estos retos, proponemos una arquitectura capaz de predecir los fallos de casos que involucran a Jueces nunca vistos, es decir, un enfoque zero-shot. Más allá de los Jueces de nuevo nombramiento, esta arquitectura permite evaluar escenarios hipotéticos (v.g.: comprobar cómo cambia el fallo al incluir u omitir a un Juez concreto, aunque esa persona nunca haya ejercido en SCOTUS). La arquitectura se basa en la hipótesis:
"La biografía de un Juez de SCOTUS incluye información relevante que determinará el sentido de su voto."
Intuitivamente, la trayectoria y la experiencia profesional moldean la visión de una persona. Conocer la biografía de un Juez debería, por tanto, orientar sus posiciones generales y la perspectiva que aporta a un caso.
Formalmente, SCOTUS-Net y SCOTUSbot no se entrenan sobre el mismo problema, sino para aprender distribuciones condicionales distintas. El primero se entrena para aprender la probabilidad del fallo del Tribunal () dada la distribución conjunta de la descripción del caso () y el conjunto de biografías de los Jueces (); mientras que el segundo se entrena para aprender la probabilidad del fallo de un Juez () dada la distribución conjunta de la descripción del caso () y la identidad del Juez (), lo que limita al modelo a aprender únicamente del historial de voto de ese Juez.
Objetivo de SCOTUS-Net (Fórmula 2.1):
Objetivo de SCOTUSbot (Fórmula 2.2):
Además de SCOTUSbot [1], de The Economist, Katz, Bommarito y Blackman presentaron un modelo de bosque aleatorio evolutivo en el tiempo que alcanzó un 70% de precisión sobre más de 7.000 casos de SCOTUS. Su diseño entrenaba y evaluaba el modelo por periodo: los datos de los periodos se usaban para el entrenamiento, y las predicciones se evaluaban sobre . Dado que los periodos de SCOTUS abarcan más de un año, este planteamiento obligaba al modelo a lidiar con los dos retos ya mencionados: el data drift y los efectos de cold-start ante nuevos nombramientos. Esto implicaba la necesidad de reentrenar el modelo cada año en producción.
El modelo de Katz, Bommarito y Blackman también dependía exclusivamente de datos estructurados, lo que genera problemas de alta cardinalidad. Estas limitaciones motivan la exploración de enfoques alternativos. En concreto, SCOTUS-Net puede entenderse como un paso hacia la aplicación de métodos de deep learning y PLN en este dominio, más allá de las variables estructuradas, hacia representaciones más complejas.
3Pipeline de datos
3.1Fuentes
Al no haber acceso a los datos utilizados por SCOTUSbot [1], se decidió basar nuestro modelo en otras fuentes de datos fiables. Estas incluyen:
Biografías de los Jueces: incluye a todos los Jueces que han ejercido en SCOTUS hasta 2025, extraídas de la página de Wikipedia de cada Juez [2]. Aunque puede considerarse una fuente sesgada o no académica, el uso de las biografías de Wikipedia sienta un precedente escalable para ampliar los usos de SCOTUS-Net. Dado que un gran número de personas relevantes cuentan con una biografía en Wikipedia, este método de entrenamiento permitirá poner a prueba muchos más escenarios hipotéticos en producción.
The Supreme Court Database (SCDB), de la Universidad de Washington [3]: se usa para construir un conjunto de datos con los fallos, identificadores y Jueces participantes de cada caso; cubre los casos de 1946 a 2023. Esta fuente ya había sido utilizada por Katz et al., por lo que se consideró una base de datos fiable.
Justia, del Tribunal Supremo de EE. UU. [4]: proporciona las opiniones de los casos, de las que se extraen las descripciones. Al tratarse del sitio web oficial de SCOTUS, se considera una fuente de datos muy reputada.
3.2Recolección y limpieza
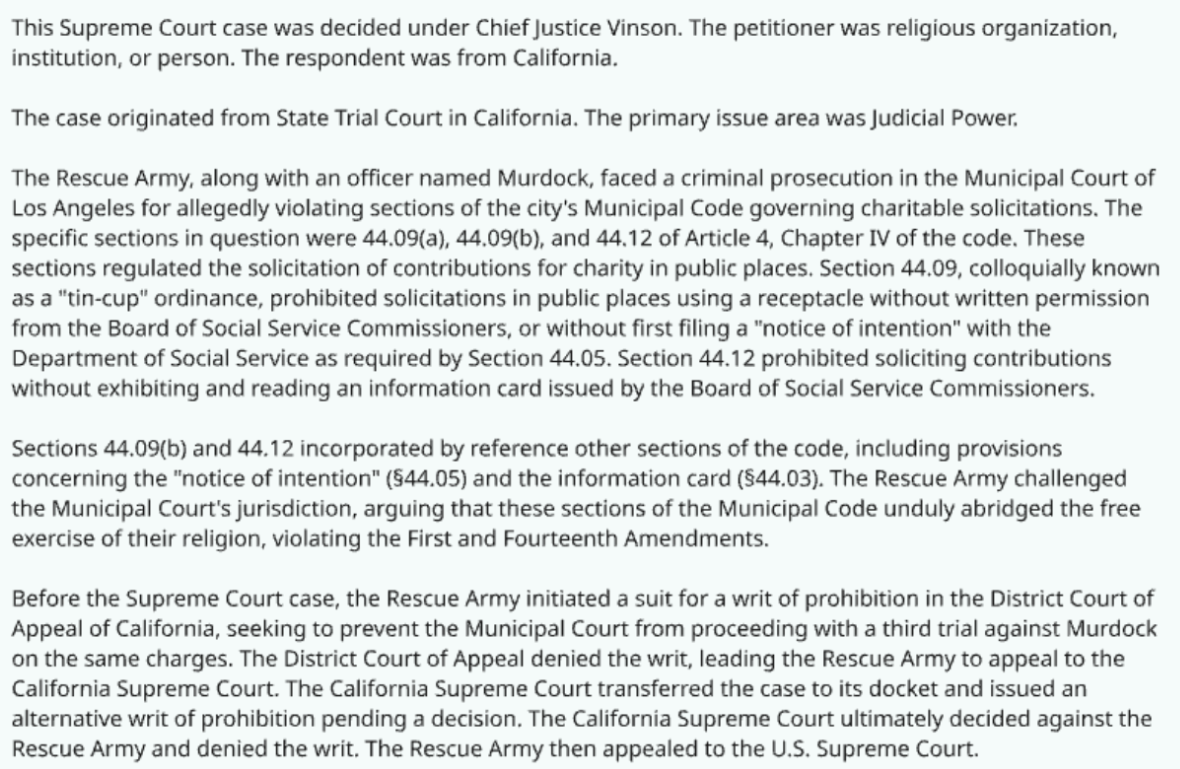
Todos los datos pasan por un pipeline de dos etapas: de crudos a procesados. Las biografías en crudo se extraen de Wikipedia y se guardan en disco. Las opiniones en crudo se recuperan de Justia usando el identificador de SCDB. Las biografías se truncan después, para evitar fugas de información (más detalles a continuación, en Divisiones y control de fugas). Las descripciones de los casos se generan incitando a la API de Gemini 2.5 [5] con una temperatura mínima, para reducir las alucinaciones. Figura 1 es un ejemplo de una descripción de caso generada con este método.
3.3Etiqueta
A partir de los votos de SCDB se construyen tres etiquetas: a favor (F) del peticionario, en contra (A) del peticionario, y ausente (B). Las etiquetas se representan como un vector de probabilidad de tres componentes que suma uno, modelando una distribución discreta sobre los tres resultados.
El mapeo de la disposición/resultado del caso en SCDB [3] a las etiquetas fue:
A favor del peticionario (F): suspensión, petición o moción concedida (1); revocado (3); revocado y devuelto (4); anulado y devuelto (5); confirmado y revocado/anulado en parte (6); confirmado y revocado/anulado en parte y devuelto (7); anulado (8).
En contra del peticionario (A): confirmado (2); petición denegada o apelación desestimada (9).
Poco claro/otro (B): certificación desde/hacia un tribunal inferior (10); sin disposición (11).
Dos notas:
La etiqueta (B) es necesaria porque los Jueces a veces están ausentes (v.g.: jubilación, fallecimiento) o se inhiben (v.g.: conflicto de intereses), y también se usa como etiqueta por defecto en fallos poco claros.
Los votos no se distribuyen de forma uniforme. En nuestra muestra, el Tribunal falla a favor del peticionario en torno al 70% de las veces, lo que produce un conjunto de datos relativamente desequilibrado. Esto condicionará ciertas decisiones y consideraciones.
3.4Divisiones y control de fugas
Existen numerosas vías potenciales de fuga de información al estructurar el problema y los datos. Las siguientes son las que hemos identificado, junto con las mitigaciones propuestas:
Las opiniones contienen el fallo: entrenar sobre las opiniones filtraría la respuesta correcta. Por ello, usamos las opiniones únicamente para extraer, vía Gemini 2.5 [5], una descripción del caso sin fugas, restringiendo los resúmenes a la presentación del caso (v.g.: peticionario, causa, etc.) y no al fallo.
Las biografías incluyen hechos del mandato en SCOTUS: no disponibles en el momento de la inferencia, especialmente bajo cold-start. Truncamos las biografías en el momento del nombramiento al Tribunal.
Referencias temporales y precedentes: en los sistemas de derecho consuetudinario, los casos más recientes tienden a citar fallos anteriores. Para evitar entrenar con información de la época de los casos de prueba, usamos divisiones basadas en el tiempo, en las que el entrenamiento es estrictamente anterior a la validación, con un conjunto de prueba reservado que cubre los últimos veinticinco años.
Biografías que citan casos de SCOTUS: incluso las biografías truncadas pueden referenciar fallos de SCOTUS si la actividad legal previa del Juez implicaba citar fallos de SCOTUS como precedentes, algo especialmente frecuente en sistemas de derecho consuetudinario. La división basada en el tiempo limita este riesgo en validación y prueba, porque el modelo se entrena con Jueces más antiguos, menos propensos a referenciar casos recientes.
3.5Nota ética
Más allá de reconocer a los proveedores de datos, cabe señalar que los datos fueron extraídos mediante scraping. Ninguna de las fuentes lo prohíbe explícitamente, aunque algunas lo desaconsejan. Dado el pequeño alcance del proyecto, se asume un impacto mínimo, respetando en todo caso la atribución y un acceso responsable.
4Diseño del modelo
4.1Arquitectura de SCOTUS-Net
Dos pipelines paralelos, Justice-Bio y Case-Description, procesan las entradas por separado para cada punto de datos: un conjunto de n biografías de Jueces y una única descripción de caso.
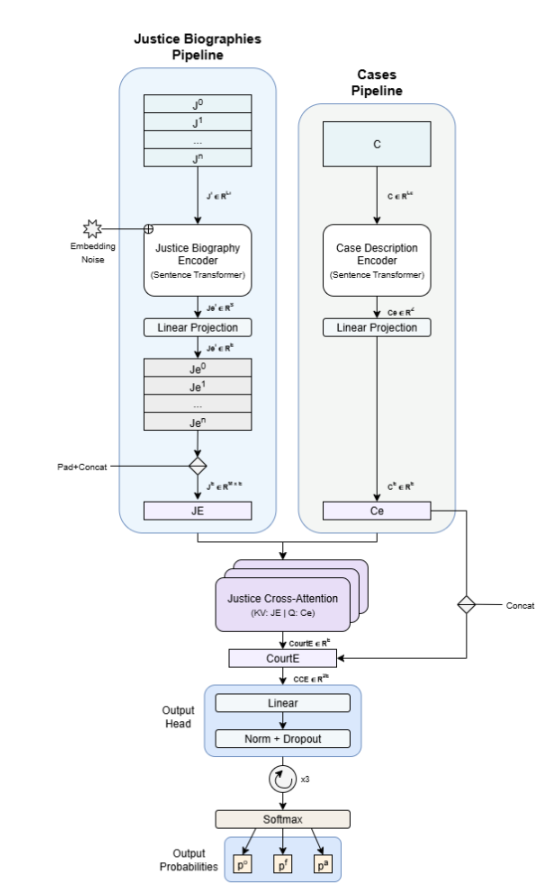
Pipeline Justice-Bio: la entrada es un conjunto de biografías de longitud variable. Un sentence transformer preentrenado [6][7] produce vectores de tamaño fijo tras aplicar una regularización NEFTune en la capa de embedding [8]. Cada vector se proyecta linealmente a la dimensión de embedding . La concatenación produce un tensor .
Pipeline Case-Description: la descripción del caso se codifica mediante un sentence transformer a longitud , y después se proyecta linealmente a , sin compartir los pesos con la proyección de los Jueces.
Cross-attention de los Jueces: dado el tensor de los Jueces y el embedding del caso , aplicamos cross-attention [9] usando como consulta para recuperar los rasgos biográficos más relevantes para el caso. La salida es un Court-Embedding contextualizado por el caso, que se concatena con — una conexión de tipo residual [10] — para preservar la información del caso.
El vector resultante, de dimensión , se pasa a un bloque totalmente conectado con tres neuronas de salida y activación Softmax, para predecir la distribución del resultado.
4.2Preentrenamiento del codificador de Jueces
SCOTUS-Net depende de dos sentence transformers preentrenados, uno para el pipeline Justice-Bio y otro para el pipeline Case-Description. Dado que el rendimiento zero-shot depende críticamente del codificador de Jueces, introducimos una etapa de preentrenamiento diseñada para garantizar que una biografía truncada codifique información relevante sobre el mandato.
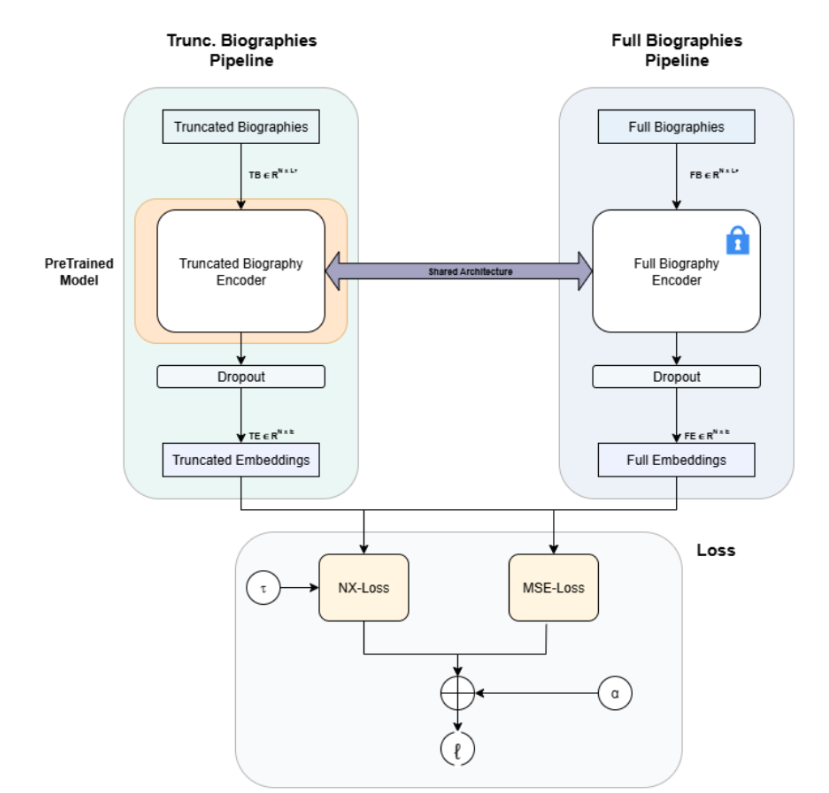
El montaje (Figura 3) involucra dos codificadores con arquitectura e inicialización compartidas:
T-Encoder (truncado), que recibe biografías truncadas en el momento del nombramiento.
F-Encoder (completo), que recibe las biografías completas. Sus pesos están congelados.
El T-Encoder se optimiza y después se transfiere al pipeline de Jueces, mientras que el F-Encoder actúa como referencia fija. El objetivo de entrenamiento es acercar los embeddings del T-Encoder a los del F-Encoder, bajo la premisa de que la biografía completa contiene información relevante sobre el mandato ausente en la versión truncada.
Esto se logra combinando dos pérdidas: NT-Xent [11] y un término basado en similitud, ponderados entre sí (más detalles a continuación, en Funciones de pérdida). De este modo, el codificador truncado se ve explícitamente incentivado a aproximar el espacio de representación, más rico, de la biografía completa.
4.3Funciones de pérdida
SCOTUS-Net se optimiza mediante una pérdida de divergencia KL (Fórmula 4.1) entre la distribución de probabilidad predicha y la distribución real de la etiqueta. Esta elección refleja la naturaleza probabilística de la tarea, en la que cada etiqueta — F, A, B — se modela como componente de una distribución de tres clases. Al minimizar la divergencia KL, el modelo aprende a alinear su distribución de salida con la distribución real, en lugar de limitarse a predecir la clase más probable. No obstante, para explorar otras posibilidades y comprobar la utilidad de esta implementación de la función de pérdida, se decidió usar una pérdida MSE como referencia (más detalles a continuación, en Experimentos).
(Fórmula 4.1)
Para la evaluación, reportamos el F1-Macro sobre el resultado de los casos. Esta métrica da igual importancia a cada clase, evitando que los resultados minoritarios queden eclipsados por la clase mayoritaria. Esto es especialmente relevante dado el desequilibrio de clases ya mencionado.
El preentrenamiento del codificador de Jueces emplea el objetivo contrastivo descrito más arriba, en Preentrenamiento del codificador de Jueces. En concreto, se incentiva al T-Encoder a aproximar el espacio de embeddings del F-Encoder mediante una pérdida combinada (Fórmula 4.4): un término contrastivo NT-Xent [11] para separar los pares positivos de los negativos (Fórmula 4.2), y un término de maximización de similitud (v.g.: similitud coseno o MSE) (Fórmula 4.3). Ambos se ponderan mediante el hiperparámetro , que equilibra la contribución de la alineación y la de la similitud. Este montaje garantiza que las biografías truncadas retengan y expresen información relevante sobre el mandato pese a su contenido reducido.
(Fórmula 4.2)
(Fórmula 4.3)
(Fórmula 4.4)
4.4Implementación y detalles de entrenamiento
Tanto para el preentrenamiento como para el entrenamiento, el entorno virtual utilizado fue Ubuntu 22.04 con Python 3.10, y CUDA 12.1.0 con acceso a una GPU NVIDIA T4 Tensor Core. Los modelos se construyeron con la última versión de PyTorch [12], optimizados con AdamW [13], y utilizando la librería sentence-transformers de HuggingFace [14]. Por último, todo el ajuste de hiperparámetros se llevó a cabo mediante búsqueda bayesiana con el paquete Optuna [15].
Cabe señalar que las limitaciones presupuestarias y de tiempo de GPU limitaron el entrenamiento del modelo a 15 épocas y la optimización de hiperparámetros a 100 pruebas, tanto para el preentrenamiento como para la tarea principal. Esto implica que existe margen para escalar el rendimiento tanto del codificador de Jueces como de SCOTUS-Net si se invierte más.
5Experimentos
5.1Referencia para el preentrenamiento del codificador de Jueces
Para evaluar el codificador de Jueces preentrenado, lo comparamos con el sentence transformer sin ajustar. El codificador ajustado debería superar esta referencia si efectivamente está aprendiendo a anticipar señales relevantes sobre el mandato a partir de biografías truncadas.
5.2Ablaciones y sensibilidades
Para estudiar la sensibilidad del modelo a la presencia de metadatos del Juez (v.g.: presidente que lo nominó, época del mandato, estado), se preparó una versión de las biografías en la que estos datos fueron eliminados. Esto permite entender cuál es la contribución de esta información al rendimiento global en el momento de la prueba.
Además, se realizaron dos experimentos de entrenamiento: primero, entrenar el modelo con o sin el codificador de Jueces preentrenado; y, segundo, entrenar con distintas pérdidas. Como se mencionó más arriba, en Diseño del modelo, se tomaron tanto MSE como KL como objetivo. La hipótesis es que el modelo entrenado con divergencia KL superaría al entrenado con MSE, ya que este aprendería mejor la distribución condicional .
6Resultados y análisis
6.1Preentrenamiento
La escasez de datos fue un reto central: solo 116 personas han ejercido en SCOTUS. El entrenamiento contó con menos de 70 muestras, y el conjunto de prueba, con solo 20 biografías. Por ello, hacemos hincapié en los intervalos de confianza al 95%, dado que las estimaciones puntuales son menos fiables a esta escala.
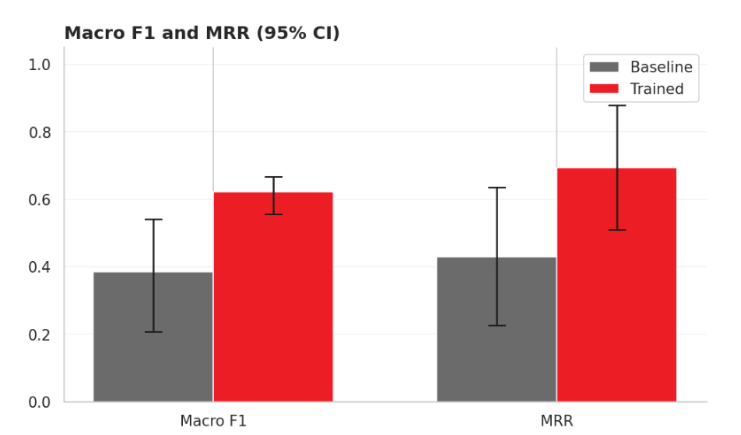
El preentrenamiento contrastivo del codificador de Jueces produjo un Mean Reciprocal Rank (MRR) ≈ 0,7 en la prueba, considerado alto para una tarea de recuperación difícil. Sin embargo, asumiendo una distribución t sobre los MRR, el IC del 95%, [0,5, 0,87], se solapa con el de la referencia, [0,22, 0,63], por lo que no podemos afirmar una mejora estadísticamente significativa (Figura 4).
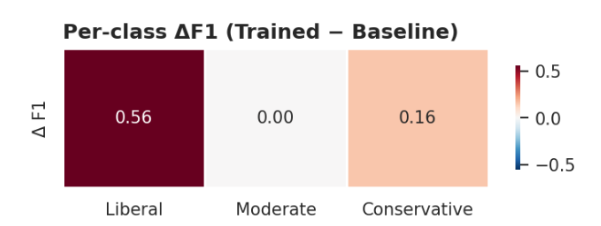
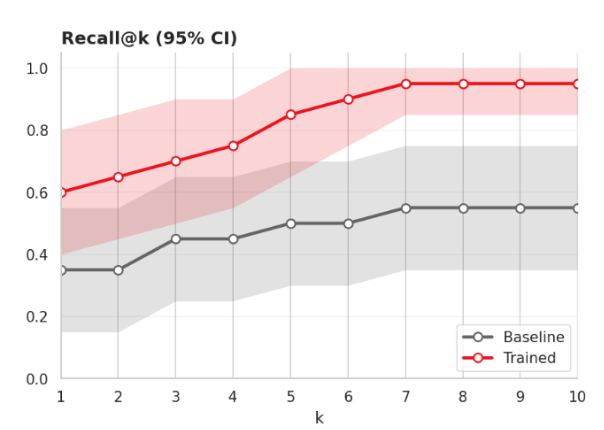
Para explorar el contenido informativo más allá del MRR, entrenamos una regresión logística simple sobre los embeddings codificados de ambos modelos, para predecir la ideología (v.g.: liberal, moderado, conservador; etiquetada manualmente). Al compartir dimensionalidad los embeddings, esto ofrece una comparación justa de su utilidad para SCOTUS-Net. El codificador de Jueces superó a la referencia en F1-Macro y en Recall@k para k ≥ 6; para k ∈ {1, …, 5} la estimación puntual favoreció al codificador principal, pero los IC se solapaban (Figura 6). Cabe destacar que los IC del F1-Macro no se solapaban, indicando una diferencia estadísticamente significativa, con mejoras por categoría de +0,56 (liberal) y +0,16 (conservador); la clase moderada se mantuvo en 0 en ambos casos (Figura 5).
6.2SCOTUS-Net
SCOTUS-Net se evaluó sobre 1.900 casos del período 1997–2023. Esto garantizó que el modelo se probara tanto con casos como con Jueces no vistos. De los quince Jueces presentes en el conjunto de prueba, solo siete se solapaban con el de entrenamiento (v.g.: J. P. Stevens, S. D. O'Connor, W. Rehnquist, A. Scalia, A. Kennedy, C. Thomas, R. B. Ginsburg). La evaluación incluyó, además, cambios de distribución significativos en el panorama social y político, como el avance de la igualdad del movimiento LGBT y el inicio de la Guerra contra el Terrorismo. Estos factores conforman, en conjunto, un entorno de prueba particularmente exigente.
Tabla 1 recoge los resultados de los tres montajes experimentales — incluyendo el codificador preentrenado; excluyéndolo; e incluyéndolo mientras se eliminan los metadatos de los Jueces —, cada uno optimizado con pérdida de divergencia KL o con pérdida MSE.
| Experimentos del modelo | Error MSE — Preentrenado | Error MSE — Sin preentrenar | Error MSE — Sin metadatos | Divergencia KL — Preentrenado | Divergencia KL — Sin preentrenar | Divergencia KL — Sin metadatos | F1-Macro — Preentrenado | F1-Macro — Sin preentrenar | F1-Macro — Sin metadatos |
|---|---|---|---|---|---|---|---|---|---|
| Pérdida KL | 0,07 | 0,1 | 0,8 | 0,34 | 0,36 | 0,35 | 0,67 | 0,65 | 0,65 |
| Pérdida MSE | 0,08 | 0,09 | 0,09 | 0,38 | 0,4 | 0,41 | 0,59 | 0,55 | 0,58 |
Los modelos entrenados con divergencia KL mostraron una ligera ventaja al aprender la distribución condicional subyacente, aunque la diferencia no fue sustancial. Aun así, en las tres métricas, las configuraciones que incorporaban el codificador preentrenado lograron sistemáticamente un rendimiento superior. Y el modelo, en general, mostró resiliencia frente a los datos sin metadatos, lo que indica que la mayor parte de la información adquirida no procede simplemente de los metadatos de los Jueces, sino de los propios rasgos biográficos.
Cabe señalar que Katz et al. alcanzaron una precisión de 0,7 en la prueba, mientras que SCOTUS-Net apenas alcanzó 0,63, quedando por debajo incluso con más datos disponibles. Así, aunque esta metodología produjo resultados aceptables, no ha alcanzado el nivel del estado del arte.
7Limitaciones y mejoras
SCOTUS-Net, en su implementación actual, presenta numerosos factores limitantes y campos de mejora. A continuación, una lista no exhaustiva con propuestas para abordar cada uno.
Falta de explicabilidad: pese a los experimentos realizados, SCOTUS-Net y el codificador de Jueces preentrenado siguen siendo, en su mayor parte, modelos de caja negra. Esto no los inhabilita, pero sí limita el alcance de sus aportaciones. Mejorar la comprensión de sus pesos e interacciones es esencial para construir un sistema más útil. Por ejemplo, convendría estudiar en detalle los embeddings del codificador de Jueces, para descubrir las dimensiones más relevantes y explorar posibles agrupaciones o distancias entre Jueces en el espacio de representación.
Falta de granularidad por Juez: como se comentó más arriba, en Motivación, una de las ventajas de SCOTUSbot [1] era su predicción granular por Juez, en la que cada uno recibía una puntuación. SCOTUS-Net, en cambio, se entrenó para predecir el fallo global del Tribunal y la distribución de voto, pero carece de la capacidad de modelar la incertidumbre o los resultados a nivel de Juez individual, como sí hacía SCOTUSbot. Para lograrlo, habría que recopilar nuevos datos y reentrenar el modelo con ese objetivo. Cabría esperar un rendimiento comparable, o incluso una mejora, bajo esta formulación.
Mejor referencia para SCOTUS-Net: el modelo de referencia usado en los experimentos actuales no se entrena con la misma cantidad de datos que SCOTUS-Net, lo que limita la comparabilidad. Una referencia más sólida consistiría en sustituir el pipeline Justice-Bio por un vectorizador TF-IDF [16] sencillo. Esto permitiría comprobar la hipótesis de que la arquitectura, más compleja, de SCOTUS-Net extrae información realmente más efectiva que un enfoque basado en vocabulario.
Posibles sesgos derivados de las biografías: SCOTUS-Net se entrena para extraer hechos relevantes de la biografía de un Juez para un caso dado. Esto genera un riesgo de sesgos sistemáticos ligados al perfil de los Jueces. Por ejemplo, el modelo podría generalizar erróneamente que los Jueces católicos siempre votan (A) en contra del peticionario en casos de libertades sexuales. Auditar estos riesgos es necesario para garantizar que el modelo no reproduzca ni amplifique correlaciones espurias.
Mejores ejemplos negativos difíciles para el preentrenamiento: el codificador de Jueces se entrenó principalmente con un objetivo contrastivo, la pérdida NT-Xent [11]. Para cada par de biografía truncada y completa, los negativos eran el resto de biografías completas. Este diseño trata incluso a biografías muy distintas como negativos equivalentes, lo que debilita el aprendizaje contrastivo. El modelo probablemente se beneficiaría de negativos mejor construidos, por ejemplo integrando una medida de similitud aproximada (v.g.: TF-IDF [16]) para ponderarlos o seleccionarlos con más criterio.
8Conclusiones
Esta investigación presentó SCOTUS-Net, una nueva arquitectura para predecir los fallos del Tribunal Supremo que desplaza la señal de aprendizaje desde el historial de voto hacia las biografías de los Jueces. Este diseño permite una generalización zero-shot a Jueces desconocidos y a composiciones hipotéticas del Tribunal.
Los experimentos demostraron que es posible extraer señales del comportamiento de los Jueces a partir de rasgos biográficos, combinados con las descripciones de los casos. Esto habilita nuevas aplicaciones, como estudios de sensibilidad y la indagación sobre cómo la trayectoria de una persona influye en las decisiones del nivel más alto del sistema legal. Persisten, no obstante, limitaciones, sobre todo en interpretabilidad, sesgos y falta de granularidad por Juez.
En conjunto, SCOTUS-Net supone un avance en el modelado predictivo legal más allá de la mera predicción de resultados, ofreciendo una herramienta para explorar la dinámica judicial y el cambio institucional.
9Referencias
The Economist, «Meet SCOTUSbot, our AI tool to predict Supreme Court rulings», The Economist, 4 de junio de 2025. economist.com
Wikipedia, «Wikipedia», Wikipedia.org, 15 de enero de 2001. wikipedia.org
«The Supreme Court Database», scdb.wustl.edu. scdb.wustl.edu
Justia, «US Supreme Court Center», Justia Law, 20 de marzo de 2019. supreme.justia.com
G. Comanici et al., «Gemini 2.5: Pushing the Frontier with Advanced Reasoning, Multimodality, Long Context, and Next Generation Agentic Capabilities», arXiv.org, 2025. arxiv.org/abs/2507.06261
N. Reimers e I. Gurevych, «Sentence-BERT: Sentence Embeddings using Siamese BERT-Networks», arXiv.org, 2019. arxiv.org/abs/1908.10084
«sentence-transformers/all-roberta-large-v1 · Hugging Face», Huggingface.co, 2015. huggingface.co/sentence-transformers/all-roberta-large-v1
A. Yadav, «Understanding and Improving Noisy Embedding Techniques in Instruction Finetuning», Openreview.net, 2025. openreview.net
A. Vaswani et al., «Attention is All You Need», Advances in Neural Information Processing Systems, vol. 30, pp. 5998–6008, 2017. proceedings.neurips.cc
K. He, X. Zhang, S. Ren, y J. Sun, «Deep Residual Learning for Image Recognition», openaccess.thecvf.com, 2016. openaccess.thecvf.com
T. Chen, S. Kornblith, M. Norouzi, y G. Hinton, «A Simple Framework for Contrastive Learning of Visual Representations», proceedings.mlr.press, 21 de noviembre de 2020. proceedings.mlr.press
B. Steiner et al., «PyTorch: An Imperative Style, High-Performance Deep Learning Library», openreview.net, septiembre de 2019. openreview.net
I. Loshchilov y F. Hutter, «Decoupled Weight Decay Regularization», arxiv.org, noviembre de 2017. arxiv.org/abs/1711.05101
«sentence-transformers (Sentence Transformers)», huggingface.co. huggingface.co/sentence-transformers
T. Akiba, S. Sano, T. Yanase, T. Ohta, y M. Koyama, «Optuna: A Next-generation Hyperparameter Optimization Framework», Proceedings of the 25th ACM SIGKDD International Conference on Knowledge Discovery & Data Mining, julio de 2019. doi.org/10.1145/3292500.3330701
K. Sparck Jones, «A Statistical Interpretation of Term Specificity and Its Application in Retrieval», Journal of Documentation, vol. 28, n.º 1, pp. 11–21, enero de 1972. doi.org/10.1108/eb026526